Cómo unificar las direcciones URL de las páginas de un sitio Drupal para mejorar su indexación en Google
Detección y corrección de direcciones duplicadas con Google Search Console
Caso real en mi blog sobre Drupal 11 autoalojado en un VPS con Virtualmin. Empecé la tarde investigando cómo posicionar mejor mis artículos técnicos en Google. De acuerdo con los manuales sobre el temea, abrí Google Search Console para ver cómo se comportaban, y en lugar de una respuesta encontré una alarma: 76 páginas marcadas como «Duplicada: Google eligió otra canónica». Al inspeccionar mi artículo más visitado descubrí la raíz: Google estaba indexando la versión http://www —insegura y con www— en lugar de mi URL segura, https:// sin www. Mi sitio tenía cuatro puertas de entrada abiertas y ninguna forzaba a una sola. La solución cupo en cuatro líneas en el .htaccess de Drupal. Lo interesante es saber que el problema provenía de una configuración que Drupal deja lista pero comentada, y que en casi veinte años y muchas migraciones nunca llegué a activar.
Esa tarde no buscaba arreglar nada sino que me propuse investigar como posicionar mejor mis artículos en los buscadores. Tengo en mi blog una serie de documentación técnica —esta misma, la de problemas reales y soluciones documentadas— y llevaba tiempo con una idea en la cabeza: que esos artículos, que escribo para que alguien con mi mismo problema los encuentre por búsqueda, aparecieran bien posicionados en Google. Así que me senté a preguntarme cómo mejorar su posicionamiento.
El primer paso, el sensato, era dejar de adivinar y mirar los datos. ¿Cómo se están comportando realmente mis artículos en Google? ¿Los está indexando? ¿Los muestra en las búsquedas? Para responder eso existe una herramienta gratuita del propio Google: Google Search Console. Yo ya tenía mi dominio verificado allí desde hacía mucho tiempo, así que entré, confiado, a ver estadisticas de tráfico, clics y otros detalles.
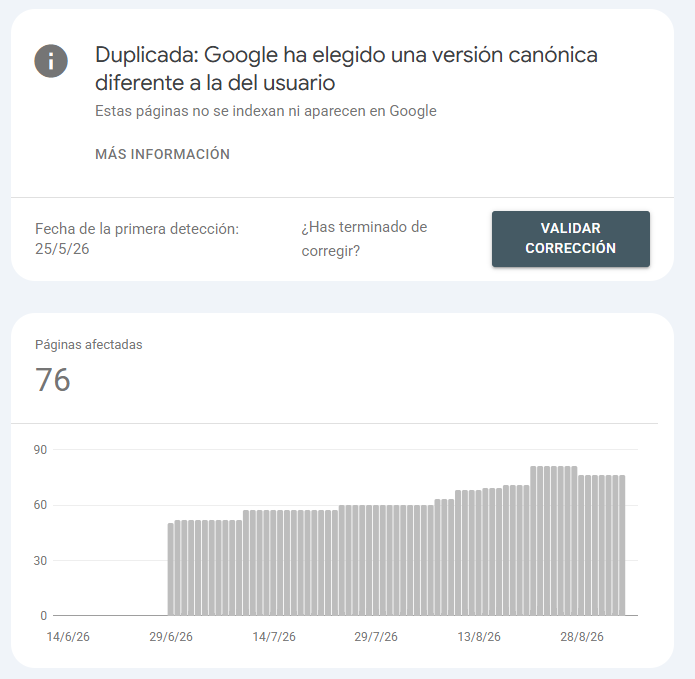
Y como suele pasar cuando uno levanta una piedra que llevaba años quieta, debajo había algo que no esperaba. En vez de confirmar que todo iba bien, Search Console me mostró una lista de problemas que yo ni sabía que existían. El que más me llamó la atención tenía un nombre que sonaba grave: 76 páginas «Duplicada: Google ha elegido una versión canónica diferente a la del usuario». No sabía qué significaba, pero setenta y seis no me pareció un número pequeño. Y como yo soy un profesor que administra su propio blog sin la ayuda de un ingeniero, si algo anda mal, me toca a mí sentarme a entender qué es y cómo arreglarlo.
Problema real
Google Search Console divide las páginas de un sitio en dos grupos: las indexadas (las que pueden aparecer en los resultados de búsqueda) y las no indexadas (las que Google conoce pero, por alguna razón, no muestra). Cuando filtré la vista para ver solo las URLs de mi sitemap —es decir, mi contenido de verdad, no el ruido que genera cualquier sitio— el panorama era este: 227 páginas indexadas y 117 sin indexar, repartidas en tres motivos.
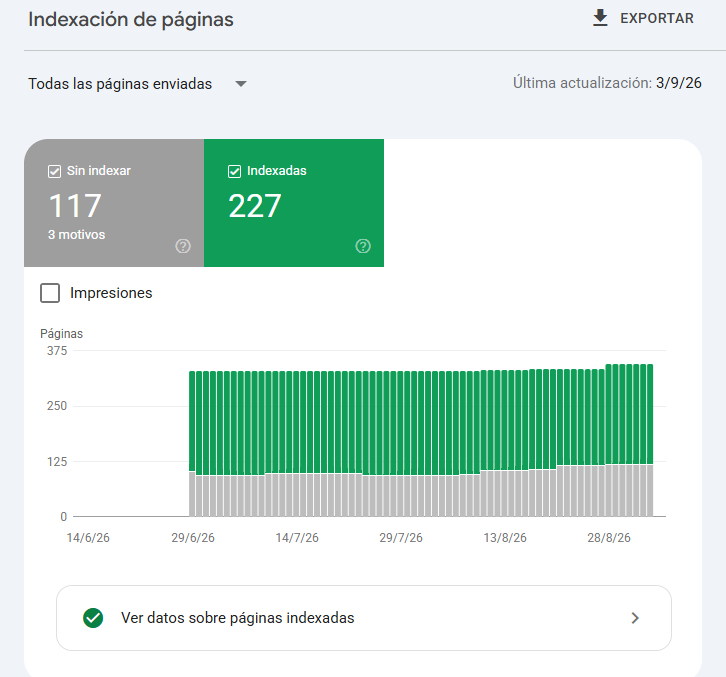
El motivo con más peso, con diferencia, era ese de las 76 páginas duplicadas. Y aquí conviene explicar qué significa «duplicada» en este contexto, porque no es lo que parece. No quiere decir que yo tenga el mismo artículo escrito dos veces. Quiere decir que Google encontró la misma página accesible desde dos o más direcciones distintas, decidió que una de ellas era la «oficial» —la canónica— y descartó las demás. El problema es que, en muchos casos, la dirección que Google eligió como oficial no era la que yo quería.
Síntoma principal
Setenta y seis páginas de mi sitio estaban marcadas como duplicadas. Google las conocía, pero en lugar de indexar la dirección que yo consideraba correcta, elegía otra versión de la misma URL. El contenido estaba bien; el problema era que la misma página existía en varias direcciones y Google no siempre se quedaba con la buena.
Para entender qué estaba pasando de verdad, tomé mi artículo más visitado —una guía sobre cómo sacar copias en tamaño oficio en una impresora HP OfficeJet, que a lo largo de los años ha acumulado más de once mil visitas— y usé la función «Inspección de URL» de Search Console, que permite preguntarle a Google, para una dirección concreta, qué sabe y qué ha hecho con ella. Lo que vi me dejó impresionado.
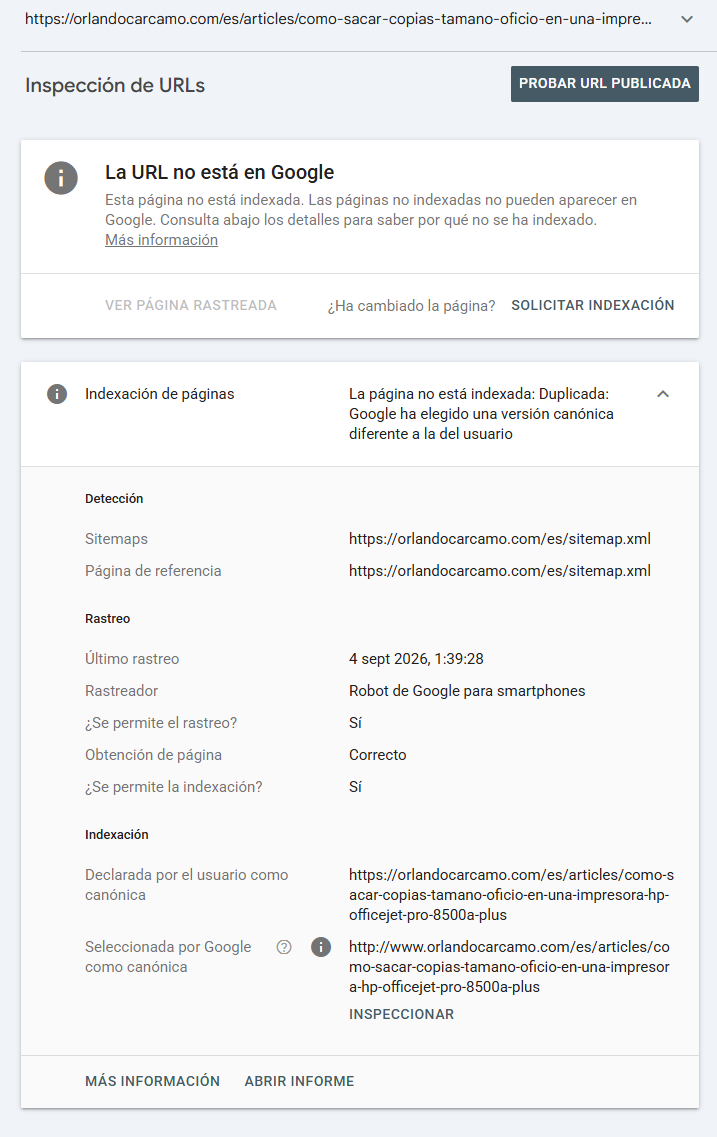
https:// sin www) y la que Google eligió por su cuenta (http://www). Es decir, Google mostraba en resultados la versión insegura y con www de mi artículo.Las dos líneas del final lo decían todo. Declarada por el usuario como canónica: https://orlandocarcamo.com/es/articles/... —la buena, segura, sin www—. Seleccionada por Google como canónica: http://www.orlandocarcamo.com/es/articles/... —vieja, insegura, con www—. Google estaba ignorando mi versión correcta e indexando una dirección que yo daba por inexistente hacía años.
Contexto mínimo
- Plataforma: Drupal 11.4.4 autoalojado en un VPS propio, gestionado con el panel Virtualmin.
- Sitio:
orlandocarcamo.com, multilingüe (español e inglés). - Servidor web: Apache, con la configuración de los VirtualHost generada por Virtualmin.
- Herramienta de diagnóstico: Google Search Console, con el dominio verificado como propiedad de tipo «Dominio».
- Componente afectado: no un archivo ni un artículo concreto, sino la forma canónica del dominio entero: qué dirección (entre http/https y con/sin www) debía ser la única válida.
Un dato que despistaba
Mi primer instinto fue pensar que el problema era el carácter multilingüe del sitio. Como cada artículo existe en español y en inglés, supuse que Google estaba confundiendo esas dos versiones como duplicados. Era una hipótesis razonable… y equivocada. La inspección de URL me sacó del error. El conflicto no era entre /es/ y /en/, sino entre http://www y https://. Guardar la sospecha para verificarla, en vez de darla por correcta, me ahorró horas en la dirección equivocada.
Causa del error o confusión
Primera hipótesis descartada: la culpa es del sitio multilingüe
La sospecha más a la mano era que las versiones en español e inglés competían entre sí. Pero la inspección de URL la descartó inmediatamente. Las dos direcciones enfrentadas eran ambas en español (/es/), solo que una con https:// sin www y la otra con http://www. El idioma no tenía nada que ver. El conflicto era de protocolo y prefijo, no de traducción.
La verdadera causa: cuatro puertas abiertas y ninguna cerrada
Todo sitio web es accesible, por defecto, desde cuatro direcciones distintas que el navegador y el servidor aceptan:
http://orlandocarcamo.com—sin cifrar, sin www—https://orlandocarcamo.com—cifrada, sin www: la que yo quería para la indexación—http://www.orlandocarcamo.com—sin cifrar, con www: la que Google eligió—https://www.orlandocarcamo.com—cifrada, con www—
Para el ojo humano, las cuatro llevan al mismo sitio. Pero para Google son cuatro páginas diferentes que contienen lo mismo, el caso de libro de contenido duplicado. Cuando eso pasa, Google elige una como canónica y, en mi caso, se estaba quedando con la vieja versión http://www.
Por qué mi etiqueta canónica no bastaba
Aquí está el matiz que más me costó entender. Drupal, gracias al módulo Metatag, sí escribe en cada página una etiqueta que le dice a Google «la versión oficial de esta página es https:// sin www». Entonces, ¿por qué Google la ignoraba? Porque una etiqueta canónica es una sugerencia, no una orden. Si las otras tres direcciones siguen vivas y respondiendo con contenido en lugar de redirigir a la buena, Google desconfía de la sugerencia y decide por su cuenta. Y eso era exactamente lo que ocurría: nada estaba obligando a que http://www a saltara a https://. La puerta vieja seguía abierta.
Lo confirmé desde la consola del servidor, pidiéndole a cada una de las tres direcciones «malas» que me dijera a dónde llevaban. Las tres respondían con una redirección… pero incompleta: cada una añadía el /es del idioma y se quedaba en su propio protocolo y prefijo. La http://www seguía siendo http://www. Nadie la mandaba a la versión segura.
La causa clave (en una frase)
Google indexaba la versión insegura de mi sitio porque las cuatro formas del dominio (http/https, con/sin www) estaban todas activas y ninguna redirigía a la canónica o segura con https://. Mi etiqueta canónica pedía una cosa, pero el servidor no la respaldaba con una redirección real, así que Google desconfiaba y elegía por su cuenta la dirección equivocada, la no segura..
Solución documentada (paso a paso)
Principio de la solución
La cura no es pedir amablemente con una etiqueta, sino obligar: hacer que cualquier visita a las tres direcciones «malas» sea redirigida, con una redirección permanente (301), a la única dirección segura. Así se cierra el problema para todo el sitio de una vez, no artículo por artículo -que llevaría demasiado tiempo-, y se le deja a Google un camino sin ambigüedad.
Paso 1 — Elegir dónde poner la redirección
En un VPS con Virtualmin hay dos sitios posibles. Uno es la configuración de Apache (los VirtualHost) y el otro es el archivo .htaccess de Drupal. Descarté editar los VirtualHost porque Virtualmin los regenera cuando uno toca el dominio desde el panel, y un cambio hecho a mano puede desaparecer en la próxima renovación del certificado SSL o ajuste de PHP. El .htaccess de Drupal, en cambio, es del usuario del dominio. Virtualmin nunca lo sobrescribe. Esa es la vía persistente.
Paso 2 — Respaldar antes de tocar es la clave para evitar futuros dolores de cabeza
Antes de cualquier edición, una copia de seguridad con fecha. Un .htaccess mal escrito puede tumbar el sitio con un error 500, así que nunca se edita sin antes generar un respaldo. Usé los siguientes comandos:
cp -a /home/USUARIO/public_html/.htaccess \
      /home/USUARIO/public_html/.htaccess.SEGURO-$(date +%Y%m%d-%H%M%S)
Paso 3 — Insertar el bloque de redirección canónica
Dentro del .htaccess, justo después de la línea RewriteEngine on (que en un Drupal 11 estándar está cerca del inicio del bloque <IfModule mod_rewrite.c>), inserté estas cuatro líneas. El comentario de la cabecera lo coloqué a propósito porque cuando uno vuelve a leer su propio código meses después, agradece que el «yo» del pasado le explique de qué se trataba. Así se recuerda rápidamente cuál es la función de las líneas de código agregadas:
  # === Normalizacion canonica: forzar https + sin www ===
  RewriteCond %{HTTP_HOST} ^www\.(.+)$ [NC,OR]
  RewriteCond %{HTTPS} !=on
  RewriteRule ^ https://orlandocarcamo.com%{REQUEST_URI} [L,R=301]
  # === Fin normalizacion canonica ===
Qué hace cada línea
La primera RewriteCond se activa si el visitante llegó con www. delante. La segunda se activa si la conexión no es segura (no es https). El [OR] entre ambas significa «si se cumple cualquiera de las dos». Y la RewriteRule es la acción: manda al visitante a https://orlandocarcamo.com seguido de la ruta exacta que pedía (%{REQUEST_URI}), con un [R=301] que le dice a Google «este cambio es permanente, actualiza tu índice». Al usar el dominio literal en el destino, el www desaparece sí o sí.
Paso 4 — Probar antes de cantar victoria
Guardado el cambio, no me fié de que «se veía bien». Le pregunté al servidor, una por una, qué hacía ahora con las tres direcciones problemáticas:
for url in "http://orlandocarcamo.com/es" \
           "http://www.orlandocarcamo.com/es" \
           "https://www.orlandocarcamo.com/es"; do
  echo "=== $url ==="
  curl -sI "$url" | grep -iE "^HTTP|^location"
done
Las tres respondieron con lo que esperaba: 301 Moved Permanently y Location: https://orlandocarcamo.com/es. Las cuatro puertas por fin convergían en una sola, la puerta segura.
Evidencia (texto y/o registros)
La prueba del antes y el después está en la respuesta del propio servidor a cada dirección. Esta es la comparación de a dónde llevaba cada URL antes y después de insertar el bloque:
| Dirección de entrada | Antes del fix | Después del fix |
|---|---|---|
http://orlandocarcamo.com/es |
se quedaba en http | → https://orlandocarcamo.com/es |
http://www.orlandocarcamo.com/es |
se quedaba en http + www | → https://orlandocarcamo.com/es |
https://www.orlandocarcamo.com/es |
se quedaba con www | → https://orlandocarcamo.com/es |
https://orlandocarcamo.com/es |
correcta (200 OK) | correcta (200 OK) |
La señal que lo confirmó todo
La prueba definitiva no fue una teoría, sino el comportamiento visible del servidor: tras el cambio, las tres direcciones «malas» devolvían un 301 apuntando a la canónica -la segura-, y la dirección buena seguía dando 200 OK sin caer en un bucle de redirecciones. Comprobar también la URL correcta es importante ya que un bloque mal escrito puede mandar la página buena a redirigirse a sí misma infinitamente.
Verificación
Consideré el problema técnicamente resuelto cuando se cumplieron estas comprobaciones:
- Las tres direcciones no canónicas devuelven
301haciahttps://orlandocarcamo.com, conservando la ruta que pidió el visitante. - La página de inicio y el artículo más visitado devuelven
200 OKsin bucles ni errores. - El cambio quedó en el
.htaccessde Drupal, que Virtualmin no regenera, de modo que es persistente frente a los cambios que se hagan desde el panel de Virtualmin. - En Search Console, usé «Solicitar indexación» sobre el artículo con la mayoría de visitas para acelerar que Google re-evalúe su canónica.
Qué queda pendiente (y por qué no es inmediato)
El arreglo técnico está hecho y es correcto, pero Search Console no refleja el cambio al instante. Google necesita volver a rastrear cada una de las 76 URLs y reevaluar su canónica, y eso toma de días a algunas semanas. El sitemap y las redirecciones 301 le marcan el camino; «Solicitar indexación» solo acelera las páginas más importantes, porque tiene una cuota diaria limitada. La confirmación final —ver «La URL está en Google» con la canónica correcta— la tendré en los próximos días, y actualizaré este artículo con esa captura del «después».
Aprendizajes y prevención
El primer aprendizaje fue que una etiqueta canónica no basta por sí sola. Es una sugerencia que Google puede ignorar si el servidor no la respalda. La sugerencia (el canonical que escribe Drupal) y la orden (la redirección 301 del .htaccess) tienen que decir lo mismo. Si se contradicen, Google confía en lo que el servidor hace, no en lo que la etiqueta dice.
El segundo aprendizaje fue no dejarme llevar por la hipótesis cómoda. Di por hecho que el problema era el sitio multilingüe, y lo lógico habría sido ponerme a revisar configuraciones de hreflang durante horas. La inspección de URL —mirar el dato concreto en vez de suponer— me señaló la causa real en un minuto: no era el idioma, era el protocolo. Escuchar la evidencia antes que la intuición sigue siendo la mejor herramienta de diagnóstico.
El tercer aprendizaje fue sobre el origen del problema, y es el que más me hizo pensar. Al revisar los respaldos de mi .htaccess, descubrí que las reglas para quitar el www venían incluidas en ese archivo de Drupal desde siempre, pero comentadas. El propio archivo trae una nota que dice «descomenta esto si quieres redirigir sin www». En casi veinte años usando Drupal, y a través de muchas actualizaciones y una reestructuración de la instalación, nunca activé esas líneas. Y cada actualización mayor regenera el .htaccess con la plantilla nueva, que vuelve a traerlas comentadas. No fue un error que cometí: fue una activación que Drupal deja en manos del administrador y que, entre migración y migración, nunca llegué a hacer. Lo raro no es haberlo tenido así; lo raro es haberlo detectado.
El cuarto aprendizaje fue de prevención, y tiene una advertencia importante: como el bloque está en el .htaccess de Drupal, una futura actualización mayor de Drupal podría regenerar el archivo y borrar el bloque recientmente agregrado. Virtualmin no lo toca, pero Drupal sí puede. Por eso este mismo artículo es mi seguro: si algún día las duplicadas reaparecen en Search Console, ya sé exactamente qué pasó y cómo se arregla en cuatro líneas. Cuando uno administra su propio servidor sin el respaldo de un experto, la documentación no es un lujo: es la memoria que uno no puede darse el lujo de perder.
Conclusión
Lo que empezó como una tarde de optimización —quería que mis artículos se encontraran mejor— terminó destapando un problema que llevaba años frenando justo eso. Mi sitio tenía cuatro direcciones abiertas y ninguna cerrada, así que Google repartía la fuerza de posicionamiento entre versiones y, para colmo, indexaba la insegura. No lo notaba nadie a simple vista: el sitio cargaba, recibía visitas, funcionaba. Pero por debajo perdía autoridad en cada búsqueda.
La solución no fue nada espectacular: cuatro líneas en el .htaccess, puestas en el lugar correcto y comprobadas con el propio servidor antes de darlas por buenas. Las cuatro puertas ahora llevan a una sola, con una redirección permanente que Google entiende sin ambigüedad. El resto —que las 76 duplicadas se vayan corrigiendo— es cuestión de que Google re-rastree, con paciencia.
Administrar el propio blog cuando uno es profesor y no una empresa con personal de mantenimiennto conlleva a que los problemas los descubra y los resuelva uno mismo, muchas veces sin buscarlos, sino por azar. Pero cada uno de esos problemas, bien entendidos y bien documentados, se convierte en conocimiento que ya no se vuelve a perder. Y esa, al final, es la idea de esta serie de problemas reales y soluciones documentadas.

- Inicie sesión o registrese para enviar comentarios